Comment on a créé NOTRE PUB iPhone 18 DEVENUE VIRALE
 Jeroen De SmetCo-founder, Callbuddy · Sep 16, 2026

Pour le lancement de nos coques iPhone 18 Pro + Pro Max, on a sorti une pub pour Callbuddy. Elle a cartonné. Et une question n'a cessé de revenir, sous nos posts comme dans nos DM, bien trop souvent pour qu'on puisse y répondre au cas par cas : comment vous avez fait ça ? Alors voilà. Tout le workflow, étape par étape, outil par outil, sans oublier les galères et ce qu'on ferait différemment la prochaine fois. Rendons à César ce qui est à César : toute la vidéo a été conçue par Matthias, le génie derrière chaque plan. Ce qui suit, c'est son workflow, retranscrit à peu près tel qu'il l'a déroulé. L'IA ouvre un champ des possibles infini. Mais la dompter est bien plus complexe qu'il n'y paraît. Si ce retour d'expérience peut vous épargner quelques-unes de nos nuits blanches, on n'aura pas écrit tout ça pour rien.
Le workflow
- Écrire l'histoire
- Générer un storyboard
- Créer les briques visuelles
- Enregistrer les éléments réutilisables
- Traduire le script en prompts vidéo
- Générer scène par scène et ajuster au fil de l'eau
- Monter la vidéo
- Musique et sound design
- Assembler la vidéo finale
1. Écrire l'histoire
Tout commence par l'histoire. On a d'abord posé les grandes lignes du concept avec ChatGPT. Une fois la base solide, on l'a transformée en script détaillé : pas seulement l'action, mais aussi les dialogues, les gags visuels, les micro-réactions des personnages et les transitions entre chaque scène. Pour nous, c'est l'étape la plus cruciale. En vidéo IA, un plan isolé a vite l'air bluffant, mais sans vraie trame narrative, on se retrouve juste avec une suite de belles images sans aucun lien. Avant de lancer la moindre génération, on voulait pouvoir répondre à ces questions : Que se passe-t-il dans chaque scène ? Que doit comprendre le spectateur à cet instant précis ? Où se trouve la touche d'humour ? Où faut-il accélérer le rythme, et où doit-on le ralentir ? Quelle information doit sauter aux yeux ? Comment passer de façon fluide et logique d'une scène à l'autre ? Plus vous verrouillez ces détails en amont, moins vous perdrez de temps en plein milieu de la génération à vous demander où va votre vidéo.
2. Générer un storyboard
L'étape suivante : donner corps à l'histoire dans Higgsfield. On a d'abord testé l'application Higgsfield Popcorn, qui génère des storyboards automatiques. On a demandé à ChatGPT de découper le script en micro-prompts de storyboard avant de les injecter dans Popcorn. C'était parfait pour vérifier en un coup d'œil si la structure visuelle tenait la route. Mais avec le recul, on ferait autrement. On commencerait plutôt par l'étape 3 : créer d'abord les personnages principaux, les décors et les accessoires. Ensuite, on monterait le storyboard nous-mêmes à partir de ces visuels grâce au générateur d'images de Higgsfield, par exemple avec Nano Banana Pro. Cette méthode offre deux avantages majeurs. D'abord, une cohérence visuelle bien plus forte dès le storyboard. Ensuite, ces images peuvent être réutilisées directement comme références pour la génération vidéo. Résultat : zéro crédit gaspillé sur des visuels jetables. Un storyboard n'a pas besoin d'être parfait. Il doit juste répondre à une question clé : est-ce que l'histoire fonctionne à l'écran ?
3. Créer les briques visuelles
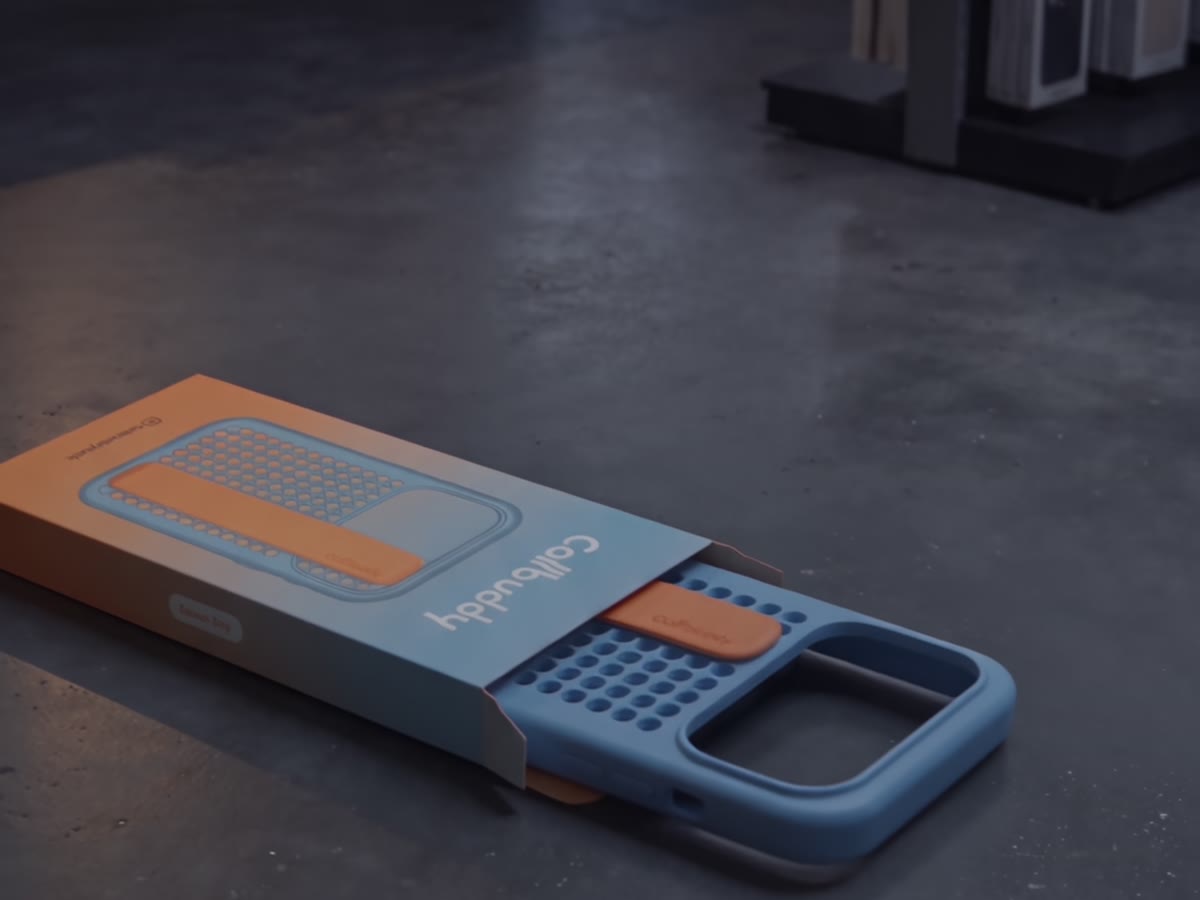
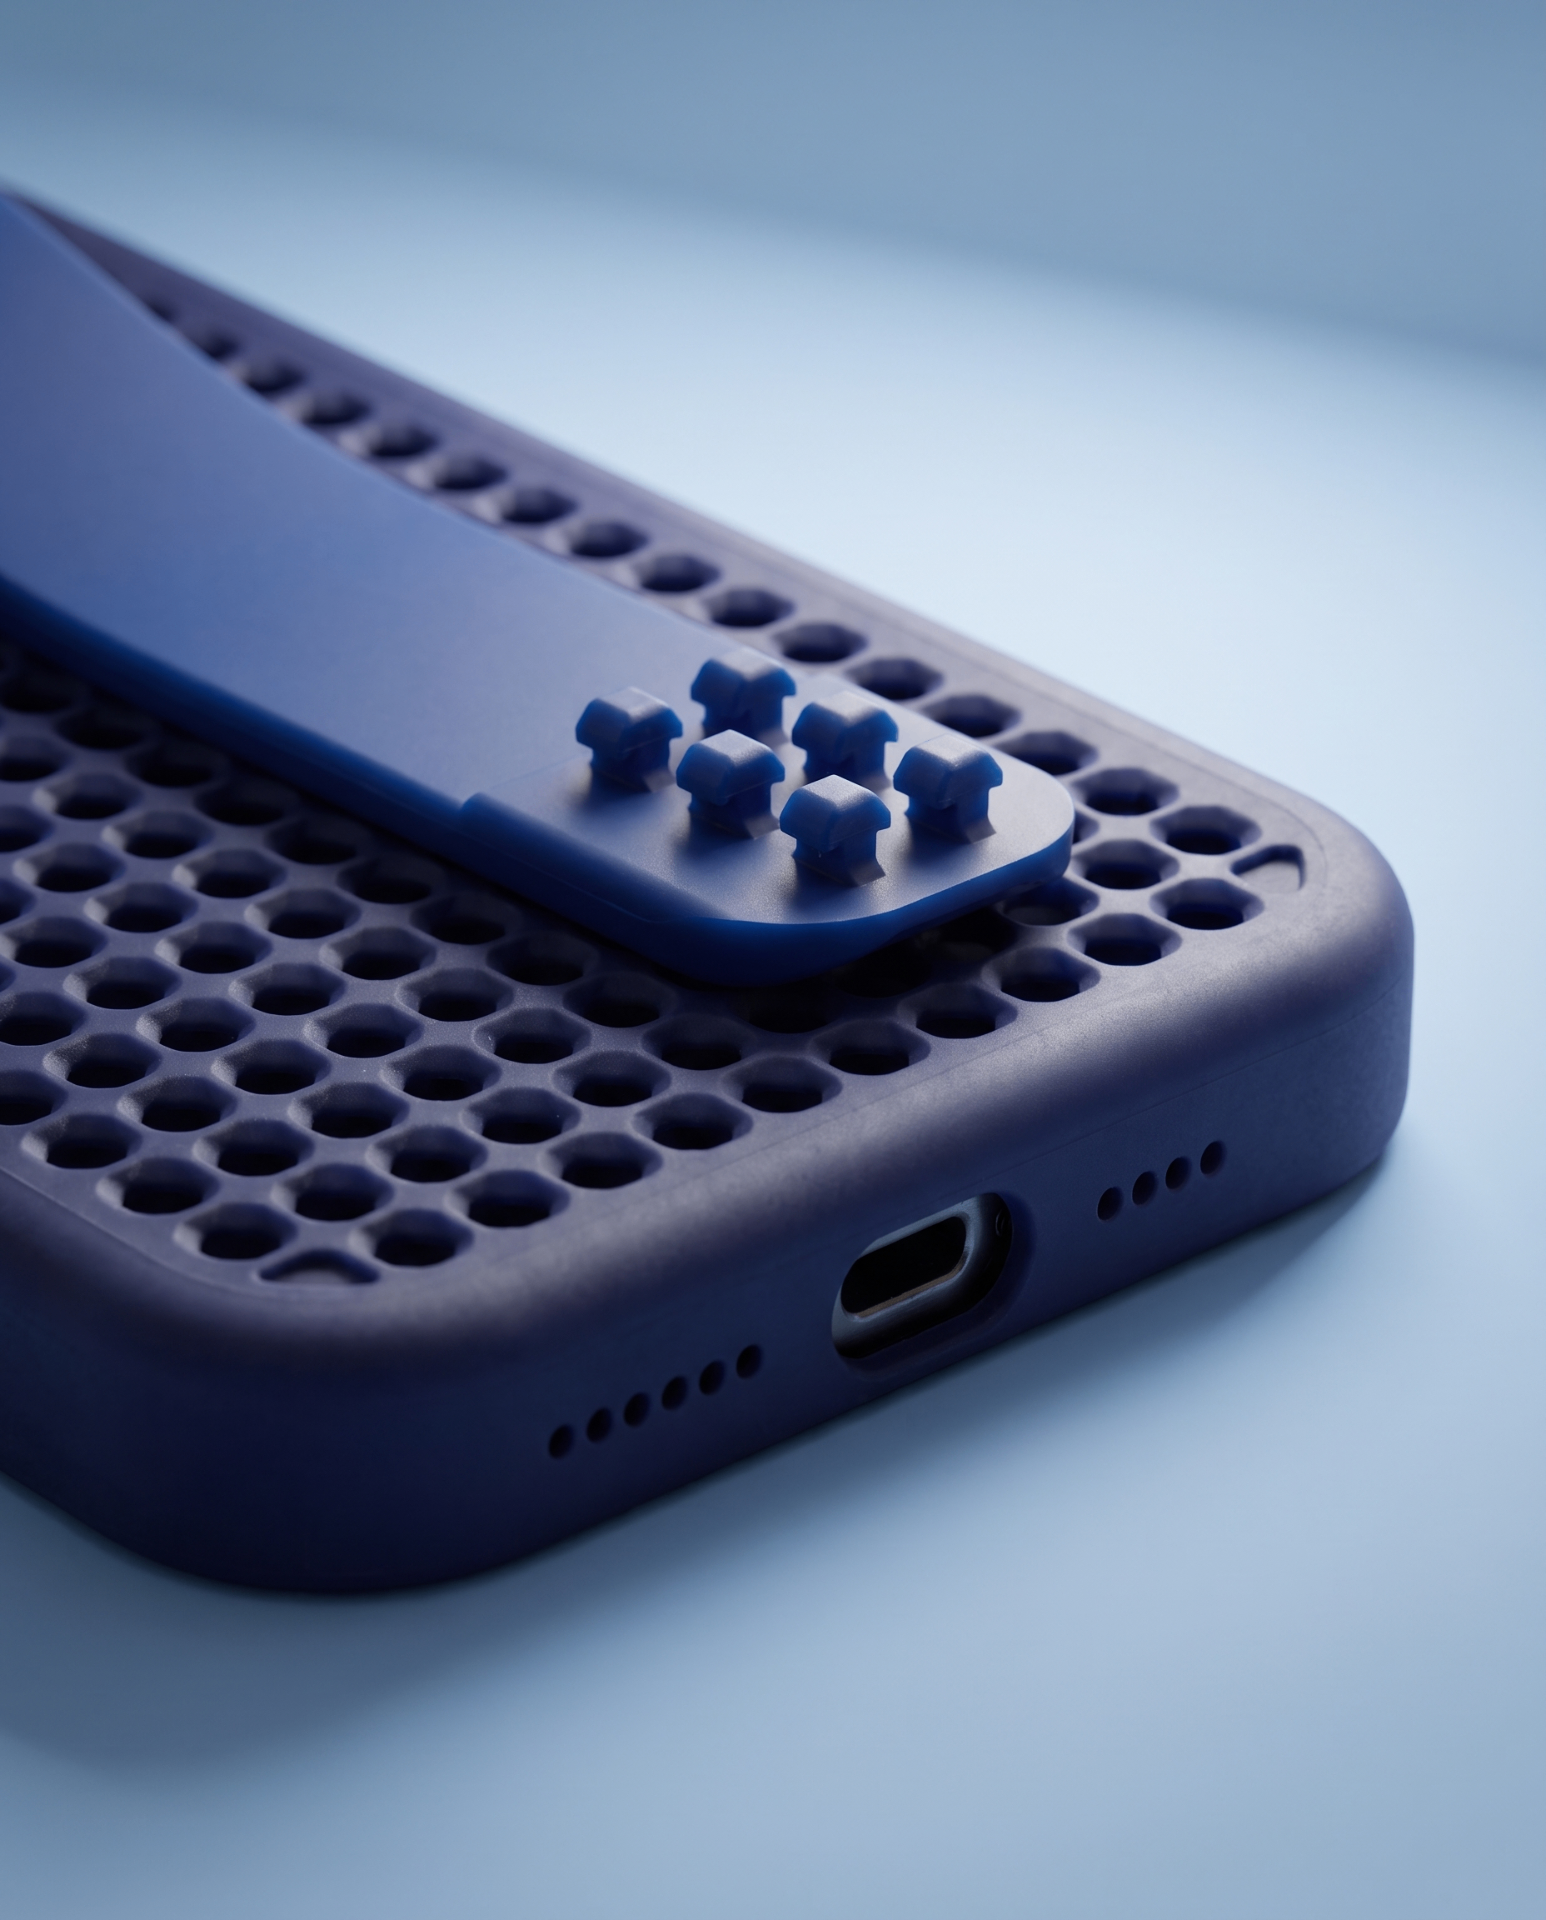
On a ensuite utilisé Nano Banana Pro dans Higgsfield pour générer chaque élément visuel récurrent de la vidéo. Dans notre cas, ça comprenait : L'agent, sous différentes tenues et dans différents états. Les personnages secondaires, parfois avec plusieurs tenues. Chaque lieu stratégique, de l'Apple Park à nos propres bureaux Callbuddy. Les accessoires : les iPhone, les coques Callbuddy, les voitures, l'écran de CAPTCHA. C'est sans doute l'étape la plus décisive de tout le processus, car ces images fixent l'univers visuel. C'est encore plus vrai pour une vidéo produit : hors de question de laisser l'IA réinventer la coque, le téléphone, un vêtement ou un bureau à chaque plan. Si un personnage apparaît dix fois, son look doit être verrouillé à l'avance. Même logique pour les décors et les produits. Plus vous cadrez les choses en amont, moins le générateur vidéo prend d'initiatives hasardeuses. Moins il a de liberté sur les éléments clés, plus le rendu final est cohérent. Mieux vaut trop en faire à cette étape que pas assez. Créez plusieurs images de référence pour un même personnage si vous savez qu'il changera d'état plus tard : tenue impeccable, vêtements abîmés, cheveux mouillés, autre veste, expression précise. C'est un gain de temps inestimable pour la suite.
4. Enregistrer les éléments réutilisables
On a ensuite enregistré ces visuels dans Higgsfield Cinema Studio sous forme de Characters, Locations et Props, chacun avec son propre tag. Résultat : au moment de rédiger un prompt vidéo, on pouvait cibler au millimètre près : Le bon personnage. Un décor spécifique. Le modèle exact d'iPhone. La bonne coque Callbuddy. Une voiture ou un accessoire précis. Au lieu de redécrire chaque élément à chaque génération, on se constitue une petite bibliothèque visuelle en amont. La génération devient bien plus fluide, et les différents plans s'enchaînent naturellement au montage.
5. Transformer le script en prompts vidéo
Ensuite, nous avons demandé à ChatGPT de découper le script complet en prompts vidéo individuels. Notre conseil numéro un : soyez aussi précis que possible. Ne laissez rien d’important à la libre interprétation du générateur vidéo. Le prompt ne décrivait donc pas seulement ce qui se passe dans la scène, mais la manière exacte dont nous voulions la filmer. Par exemple : un plan large du personnage marchant dans un couloir. Puis un gros plan sur son visage. Elle regarde une porte. Coupe rapide sur sa main qui teste la poignée. En clair, vous décrivez un mini-montage. En parallèle, nous avons précisé l’angle de caméra, les mouvements d'appareil, la valeur de plan, le moment de la journée, la météo, l’éclairage, le rythme, les actions, les réactions du personnage, la direction de son regard, les bruitages et les dialogues éventuels. Le rythme mérite d’être décrit explicitement. Pour l’infiltration, nous voulions des mouvements plus lents et furtifs. Pour la fuite, des plans rapides et beaucoup d’action. Pour certains ressorts comiques, nous voulions délibérément un silence plus long, ou un plan qui s’attarde une fraction de seconde de trop. Les dialogues et les effets sonores ont été intégrés directement dans les prompts. La musique, en revanche, a été volontairement exclue, et nous le précisions clairement dans chaque prompt : générer sans musique. Si chaque clip IA arrive avec sa propre musique, vous devez soit la couper au montage, soit vous retrouver avec plusieurs morceaux superposés. N'ajouter la musique qu'à la toute fin permet de construire une bande-son cohérente d'un bout à l'autre de la vidéo. Cela vous évite un travail monstre par la suite.
6. Générer scène par scène et ajuster au fur et à mesure
Nous avons généré la vidéo avec Higgsfield Cinema Studio et Seedance 2.5. Nous n’avons délibérément pas cherché à générer tout le film d’un seul bloc. Nous avons travaillé scène par scène, souvent plan par plan. Plus la séquence générée est courte, plus vous gardez le contrôle. Vous pouvez tenter une séquence plus longue quand l’action est relativement simple. Si le modèle comprend bien le mouvement, cela fait gagner du temps. Mais pour une action complexe, tout découper a bien mieux fonctionné pour nous. Après chaque génération, nous vérifiions plusieurs points : Le visage du personnage est-il resté cohérent ? Le mouvement est-il naturel ? Le téléphone est-il toujours le bon ? La coque Callbuddy a-t-elle changé ? Comprend-on clairement ce que regarde le personnage ? Le sens du mouvement est-il respecté ? La dernière image s’enchaîne-t-elle logiquement avec le plan suivant ? Dès que quelque chose clochait, nous modifiions le prompt ou l’image de référence avant de relancer. Une leçon précieuse : n’essayez pas toujours de corriger un mauvais résultat en rallongeant le prompt. Parfois, l’action est tout simplement trop complexe pour une seule génération. Découpez-la plutôt. Plutôt qu’un seul clip où quelqu’un marche vers une porte, l’ouvre, regarde à l’intérieur, recule et s’enfuit, créez quatre plans courts. Vous aurez infiniment plus de maîtrise au montage.
7. Le montage
Pour le montage, nous avons opté pour CapCut cette fois-ci. D'abord, nous avons téléchargé chaque génération exploitable depuis Higgsfield pour les classer dans des dossiers par scène dans CapCut. C’est là que le vrai casse-tête commence. D'une génération, vous n'utiliserez peut-être que les deux premières secondes. D'une autre, seulement le milieu. Un troisième clip aura peut-être un mouvement parfait, mais partira en vrille sur la fin. Ne considérez donc pas une génération comme une vidéo finie à utiliser telle quelle. Voyez-la comme de la matière brute. Vous fouillez dans tout ce contenu pour dénicher les fragments qui tiennent la route visuellement et qui, mis bout à bout, racontent l'histoire. Au montage, vous pouvez camoufler un paquet de défauts en coupant au bon moment. Une main commence à bugger ? Coupez juste avant. Un visage se déforme après trois secondes ? Ne gardez que les deux premières. Une action ne fonctionne pas tout à fait ? Arrêtez le plan A juste avant et démarrez le plan B juste après. Une vidéo IA ne se fabrique pas uniquement à la génération. Une grande partie prend forme au montage.
8. Musique et sound design
Pour la musique, nous avons utilisé ElevenLabs. Nous avons décrit le type de bande-son souhaité et son évolution au fil de la vidéo. Vous pouvez être très précis : commencer calmement dans la tension, monter en puissance, accélérer pendant la course-poursuite, puis couper net pour un effet comique. C’est ultra pratique, car cela permet à la musique d'épouser la structure de votre vidéo au lieu de simplement tourner en boucle en arrière-plan. Pour les bruitages additionnels, nous avons notamment pioché dans Envato. Bruits de pas, portes, voitures, clics, interfaces, ambiances de pièce et tous ces petits effets sonores qui donnent de l'impact aux actions. Au final, le sound design fait une différence colossale. Une vidéo générée avec un son médiocre crie immédiatement « IA ». Dès que chaque mouvement est soutenu par le bon son, tout devient infiniment plus crédible.
9. Assembler la vidéo finale
C’est là que tout se rassemble. Les meilleurs fragments. Le bon timing. Les dialogues. Les bruitages. La musique. Les éventuels textes ou titres. Et par-dessus tout, une multitude de micro-coupes. Pour nous, c’est l’essence même de ce workflow : verrouiller d’abord l’histoire et l’univers visuel, puis créer les personnages, les décors et les produits, générer ensuite de courtes scènes de façon ultra ciblée, et enfin exploiter le montage pour transformer le tout en un film cohérent. La pire erreur serait de foncer tête baissée sur le générateur vidéo en attendant que l’IA imagine le film à votre place. Plus vous prenez de décisions en amont, plus l’IA devient un outil de production redoutable. La génération n'est qu'une pièce du puzzle. Le vrai travail réside dans la réflexion, la préparation, la sélection et le montage. C’est la seule raison pour laquelle nous avons pu créer une vidéo où rien n’a été réellement filmé, tout en obtenant un résultat parfaitement fluide et homogène. L’idée clé : la vidéo IA donne le meilleur d'elle-même quand vous ne la laissez pas tout décider. Plus votre histoire, vos images de référence et votre découpage sont solides dès le départ, plus vos générations seront cohérentes et exploitables.
Written by
Jeroen De SmetCo-founder, Callbuddy