Come abbiamo realizzato IL NOSTRO SPOT PER iPhone 18 DIVENTATO VIRALE
 Jeroen De SmetCo-founder, Callbuddy · Sep 16, 2026

Abbiamo creato uno spot per Callbuddy in occasione del lancio delle nostre cover per iPhone 18 Pro + Pro Max. È diventato virale. E c'è una domanda che continuava a tornare nei commenti e nei nostri DM, molte più volte di quante potessimo rispondere singolarmente: come avete fatto a realizzarlo? Ed eccolo qui. L'intero workflow, ogni singolo passaggio, ogni tool, compresi gli intoppi e le cose che faremmo diversamente la prossima volta. Diamo a Cesare quel che è di Cesare: l'intero video è stato creato da Matthias, il genio dietro a ogni singola inquadratura. Quello che segue è il suo workflow, raccontato più o meno nel modo esatto in cui lo ha gestito lui. L'AI apre una quantità enorme di porte. Ma è anche molto più difficile da guidare di quanto sembri dall'esterno. Se questo articolo vi farà risparmiare anche solo una parte del tempo che è costato a noi, sarà valsa la pena scriverlo.
Il workflow
- Scrivi la storia
- Genera uno storyboard
- Crea gli elementi visivi di base
- Salva tutto come Elementi riutilizzabili
- Traduci la sceneggiatura in prompt video
- Genera scena per scena e correggi strada facendo
- Montaggio
- Musica e sound design
- Assembla il video finale
1. Scrivi la storia
Siamo partiti dalla storia. Abbiamo prima definito il concept generale con ChatGPT. Solo quando ci è sembrato solido lo abbiamo trasformato in una sceneggiatura dettagliata, definendo non solo cosa succede, ma anche i dialoghi, le gag visive, le micro-reazioni dei personaggi e le transizioni tra le scene. Secondo noi questo è il passaggio che conta di più. I video generati con l'AI diventano impressionanti a livello di singola inquadratura molto in fretta, ma senza una vera storia ti ritrovi solo con una raccolta di belle immagini slegate tra loro. Prima di generare qualsiasi cosa, volevamo essere in grado di rispondere a queste domande: Cosa succede in ogni scena? Cosa deve capire lo spettatore in quel momento? Dove sta l'ironia? Dove deve accelerare il ritmo, e dove invece deve rallentare? Quali informazioni devono essere visivamente chiare? Come passiamo in modo logico da una scena all'altra? Più aspetti chiudi all'inizio, meno tempo passerai a metà generazione cercando di capire che cosa dovrebbe essere il tuo video.
2. Genera uno storyboard
Poi abbiamo cercato di dare una forma visiva alla storia su Higgsfield. Il nostro primo approccio è stato usare l'app Higgsfield Popcorn, che genera storyboard in automatico. Abbiamo fatto dividere a ChatGPT l'intera sceneggiatura in piccoli prompt per storyboard e li abbiamo dati in pasto a Popcorn. Ha funzionato bene per verificare al volo se le linee generali della storia avessero senso a livello visivo. La prossima volta faremmo diversamente. Anticiperemmo lo step 3, creando prima i personaggi principali, le location e gli oggetti di scena. Poi costruiremmo lo storyboard direttamente da quelle immagini usando il generatore di immagini di Higgsfield, per esempio con Nano Banana Pro. Ci sono due grandi vantaggi in quest'ordine. Si ottiene molta più coerenza visiva fin dallo storyboard, e le immagini create per lo storyboard possono essere riutilizzate in seguito come immagini di riferimento per le generazioni video. Senza bruciare crediti su immagini che poi non servono più a niente. Lo storyboard non deve essere perfetto. Deve soprattutto rispondere a una domanda: la storia funziona visivamente?
3. Crea gli elementi visivi di base
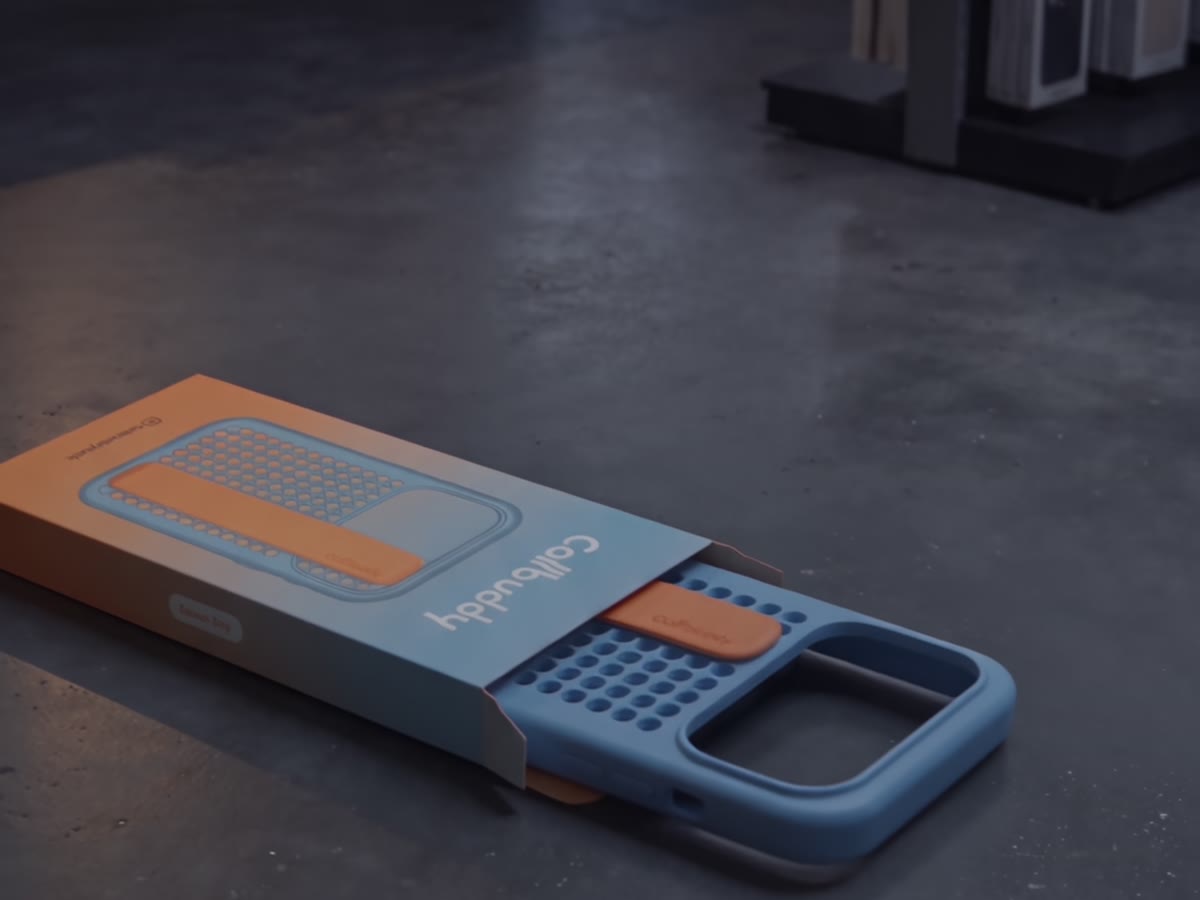
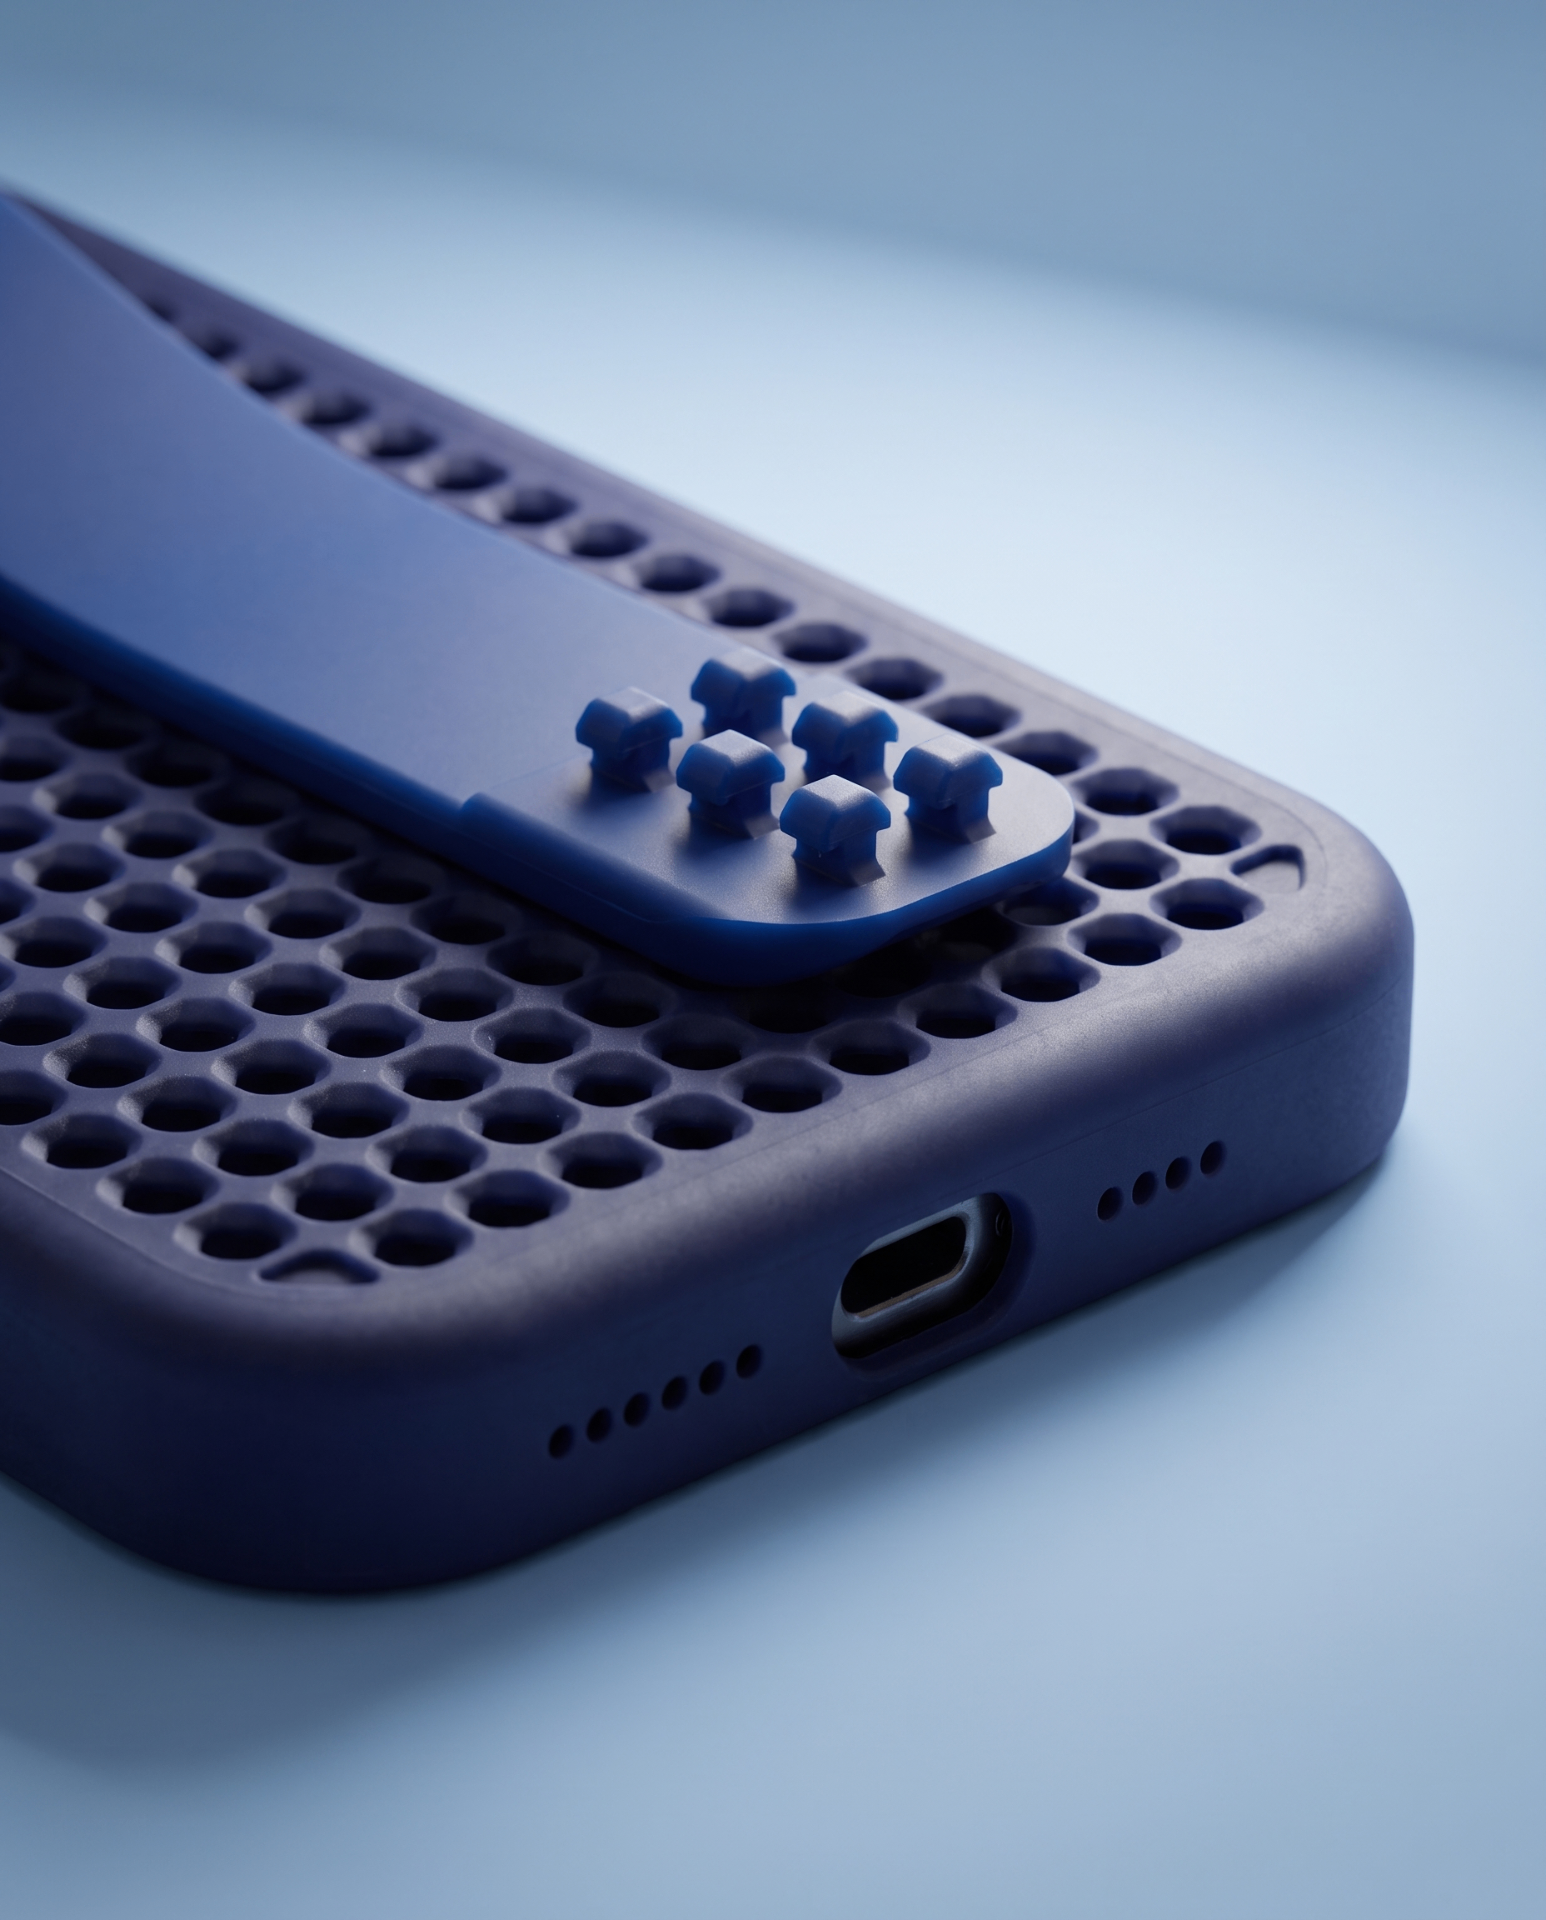
Poi abbiamo usato Nano Banana Pro su Higgsfield per creare ogni singolo elemento visivo che sarebbe ricomparso nel video. Nel nostro caso comprendeva: L'agente, con diversi outfit e stati d'animo. Gli altri personaggi, alcuni dei quali con più outfit. Ogni location importante, da Apple Park fino al nostro ufficio Callbuddy. Oggetti di scena: gli iPhone, le cover Callbuddy, le auto, la schermata del CAPTCHA. Questo è probabilmente il singolo passaggio più importante dell'intero workflow, perché queste immagini definiscono l'aspetto del tuo mondo. Vale ancora di più per un video di prodotto: non puoi permettere a un modello AI di inventarsi una cover, un telefono, un outfit o un ufficio leggermente diversi a ogni inquadratura. Se un personaggio compare dieci volte, devi aver già deciso in anticipo che aspetto ha. Lo stesso vale per location e prodotti. Più elementi definisci all'inizio, meno decisioni dovrà prendere il generatore video da solo; meno libertà ha sugli elementi cruciali, più coerente sarà il risultato finale. In questa fase è decisamente meglio prepararsi troppo che troppo poco. Crea diverse immagini di riferimento di un personaggio se sai che più avanti ti servirà in condizioni differenti: outfit normale, outfit rovinato, capelli bagnati, una giacca diversa, un'espressione specifica. Fa risparmiare una quantità enorme di tempo lungo il percorso.
4. Salva tutto come Elementi riutilizzabili
Abbiamo poi salvato quelle immagini in Higgsfield Cinema Studio come Characters, Locations e Props, ciascuno con il proprio tag. Questo significava che, durante la stesura di un prompt video, potevamo richiamare con precisione: Il personaggio giusto. Una location specifica. L'esatto iPhone. La cover Callbuddy corretta. Un'auto o un oggetto di scena specifico. Invece di ridescrivere l'aspetto di ogni cosa a ogni singola generazione, crei prima una piccola libreria visiva. Rende la generazione molto più gestibile e aumenta le probabilità che le singole inquadrature stiano davvero bene insieme in fase di montaggio.
5. Trasformare lo script in prompt video
Abbiamo poi chiesto a ChatGPT di suddividere l'intero script in singoli prompt video. Il nostro consiglio principale? Siate il più specifici possibile. Non lasciate nulla di importante all'interpretazione del generatore video. Nel prompt non abbiamo descritto solo cosa succede nella scena, ma come volevamo che venisse girata. Per esempio: campo lungo del personaggio che cammina in un corridoio. Poi primo piano del suo volto. Guarda verso una porta. Stacco rapido sulla mano che prova ad abbassare la maniglia. In pratica, state descrivendo un mini montaggio. Oltre a questo, abbiamo specificato dettagli come angolazione della camera, movimenti di macchina, scala dei piani, ora del giorno, meteo, illuminazione, ritmo, azioni, reazioni del personaggio, direzione dello sguardo, effetti sonori ed eventuali dialoghi. Il ritmo merita una descrizione esplicita. Durante l'infiltrazione volevamo movimenti più lenti e furtivi. Durante la fuga, tagli rapidi e molto dinamismo. Per alcune gag comiche abbiamo volutamente cercato un silenzio prolungato, o un'inquadratura che si trattenesse una frazione di secondo di troppo. Dialoghi ed effetti sonori sono finiti direttamente nei prompt. La musica, invece, l'abbiamo esclusa di proposito, specificandolo chiaramente in ogni prompt: generate no music. Se ogni singola clip AI arriva con la propria traccia audio, finirete per doverla rimuovere dopo o vi ritroverete con più brani sovrapposti. Aggiungere la colonna sonora solo alla fine permette di creare un sound coerente lungo tutto il video. E risparmia un sacco di lavoro dopo.
6. Generare scena per scena e correggere in corso d'opera
Abbiamo generato il video con Higgsfield Cinema Studio e Seedance 2.5. Abbiamo evitato di proposito di generare l'intero filmato in un colpo solo. Abbiamo lavorato scena per scena, spesso inquadratura per inquadratura. Più breve è la generazione, maggiore è il controllo. Si può tentare una sequenza più lunga quando l'azione è relativamente semplice. Se il modello interpreta bene quel movimento, fa risparmiare tempo. Ma per azioni complesse, spezzare tutto si è rivelata la scelta migliore. Dopo ogni generazione abbiamo controllato alcuni aspetti chiave: Il volto del personaggio è rimasto coerente? Il movimento è naturale? Il telefono è ancora quello giusto? La cover Callbuddy è cambiata? Si capisce cosa sta guardando il personaggio? La direzione del movimento è corretta? L'ultimo frame si raccorda in modo logico con l'inquadratura successiva? Non appena qualcosa sembrava strano, modificavamo il prompt o l'immagine di riferimento e generavamo di nuovo. Una lezione fondamentale: non cercate sempre di correggere un risultato venuto male aggiungendo altro testo allo stesso prompt. A volte l'azione è semplicemente troppo complessa per una sola generazione. Dividetela. Invece di un'unica clip con qualcuno che cammina verso una porta, la apre, guarda dentro, si ritrae spaventato e scappa via, create quattro inquadrature brevi. In fase di montaggio avrete infinitamente più controllo.
7. Montaggio
Questa volta per il montaggio abbiamo scelto CapCut. Per prima cosa abbiamo scaricato da Higgsfield ogni generazione utilizzabile, organizzandole in cartelle per scena su CapCut. Ed è lì che comincia il vero puzzle. Di una generazione potresti usare solo i primi due secondi. Di un'altra, solo la parte centrale. Una terza clip potrebbe avere un movimento perfetto, ma allucinare sul finale. Non considerate una generazione come un video finito da usare per intero. Trattatela come materiale grezzo. L'obiettivo è setacciare tutto alla ricerca dei frammenti che reggono visivamente e che, insieme, raccontano la storia. In fase di montaggio si possono nascondere moltissimi difetti semplicemente tagliando al momento giusto. Una mano comincia a deformarsi? Tagliate prima che succeda. Un viso cambia fisionomia dopo tre secondi? Usate solo i primi due. Un'azione non convince fino in fondo? Chiudete l'inquadratura A un attimo prima e aprite la B subito dopo. I video con l'AI non nascono solo durante la generazione: gran parte del risultato si costruisce al montaggio.
8. Musica e sound design
Per la musica ci siamo affidati a ElevenLabs. Abbiamo descritto il tipo di colonna sonora di cui avevamo bisogno e come doveva evolversi nel corso del video. Si può entrare molto nel dettaglio: inizio calmo e teso, crescendo graduale, accelerazione durante l'inseguimento e poi uno stacco netto per una battuta comica. È un approccio prezioso, perché permette alla musica di seguire la struttura della storia invece di limitarsi a scorrere sotto. Per gli effetti sonori aggiuntivi abbiamo utilizzato, tra le varie risorse, Envato: passi, porte, auto, clic, interfacce, rumori d'ambiente e tutti quei micro-effetti che danno impatto alle azioni. Il sound design fa una differenza enorme. Un video generato con un audio debole continua a sembrare palesemente fatto con l'AI. Ma non appena i movimenti hanno il suono giusto, tutto diventa incredibilmente più credibile.
9. Assemblare il video finale
Poi tutto si unisce. I frammenti migliori. Il timing perfetto. Dialoghi. Effetti sonori. Musica. Testi o titoli. E soprattutto, un'infinità di micro-tagli. Per noi è questa l'essenza del workflow: definire prima di tutto la storia e l'universo visivo, poi costruire personaggi, location e prodotti, quindi generare scene brevi in modo mirato e sfruttare il montaggio per trasformare il tutto in un film coerente. L'errore più grande sarebbe buttarsi a capofitto nel generatore video e aspettarsi che l'AI crei il film al posto vostro. Più decisioni prendete a monte, meglio funzionerà l'AI come strumento di produzione. La generazione è solo una parte del processo. Il vero lavoro sta nell'ideazione, nella preparazione, nella selezione e nel montaggio. È solo così che siamo riusciti a creare un video in cui nulla è stato realmente girato, facendolo sembrare un'opera unica e solida. Il concetto di fondo: i video AI funzionano al meglio quando non si lascia decidere tutto all'AI. Più solide sono la narrazione, le immagini di riferimento e la pianificazione delle inquadrature a monte, più coerenti e utilizzabili saranno le generazioni.
Written by
Jeroen De SmetCo-founder, Callbuddy